FlexInference: Drop your AI costs today
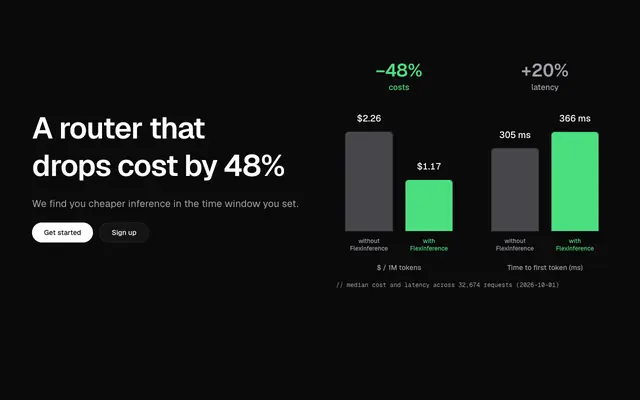
FlexInference helps you reduce AI costs by routing your LLM API requests across multiple providers to achieve cost savings and meet latency targets.
api sdk★ 0.00 reviews
Details
FlexInference helps you reduce AI costs by routing your LLM API requests across multiple providers to achieve cost savings and meet latency targets.
Recent reviews
No reviews yet